Automatic speech recognition (ASR) adalah teknologi yang membuat komputer bisa mengenali kata yang diucapkan dan mengubahnya menjadi teks. Dalam Bahasa Indonesia ia disebut pengenalan ucapan atau pengenalan wicara. Teknologi inilah yang bekerja di balik dikte suara, teks otomatis di video, transkripsi rapat, dan asisten suara.
Kalau pernah mendikte pesan lalu melihat kata-katamu muncul di layar, kamu sudah memakai ASR. Kalau pernah kesal karena nama temanmu ditulis menjadi kata lain, kamu juga sudah melihat batasannya. Keduanya bisa dijelaskan dari cara ASR bekerja.
Artikel ini menjelaskan pengertian automatic speech recognition, alurnya dari suara sampai teks, sejarah singkatnya, cara mengukur akurasinya, dan faktor yang membuat hasilnya naik turun. Penjelasannya sengaja disederhanakan untuk pembaca umum, dengan sumber yang bisa kamu telusuri lebih jauh.
Automatic speech recognition adalah
Menurut Wikipedia bahasa Indonesia, pengenalan ucapan adalah pengembangan teknik dan sistem yang memungkinkan komputer menerima masukan berupa kata yang diucapkan. Hasilnya bisa berupa tulisan, atau dibaca perangkat sebagai perintah untuk melakukan sesuatu, misalnya menekan tombol di telepon secara otomatis dengan komando suara.
Dari definisi itu ada dua kegunaan besar. Yang pertama adalah transkripsi atau dikte: suara menjadi tulisan yang bisa dibaca dan diedit. Yang kedua adalah perintah suara: suara menjadi aksi, seperti "putar lagu" atau "telepon ibu". Keduanya memakai mesin yang sama di tahap awal, yaitu mengenali kata apa yang diucapkan.
Speech recognition adalah istilah yang sering dipakai bergantian dengan ASR. Kata "automatic" menegaskan bahwa yang mengenali adalah mesin, bukan manusia. Istilah speech to text biasanya merujuk ke fungsi atau produknya, sedangkan ASR adalah nama bidang teknologinya. Untuk keperluan sehari-hari, perbedaan ini tidak terlalu penting.
Yang perlu dibedakan adalah ASR dengan pengenalan pembicara. ASR menjawab pertanyaan "apa yang diucapkan", sedangkan pengenalan pembicara menjawab "siapa yang bicara". Aplikasi transkripsi rapat yang memberi label "Pembicara 1" dan "Pembicara 2" memakai keduanya.
Cara kerja ASR, dari suara sampai teks
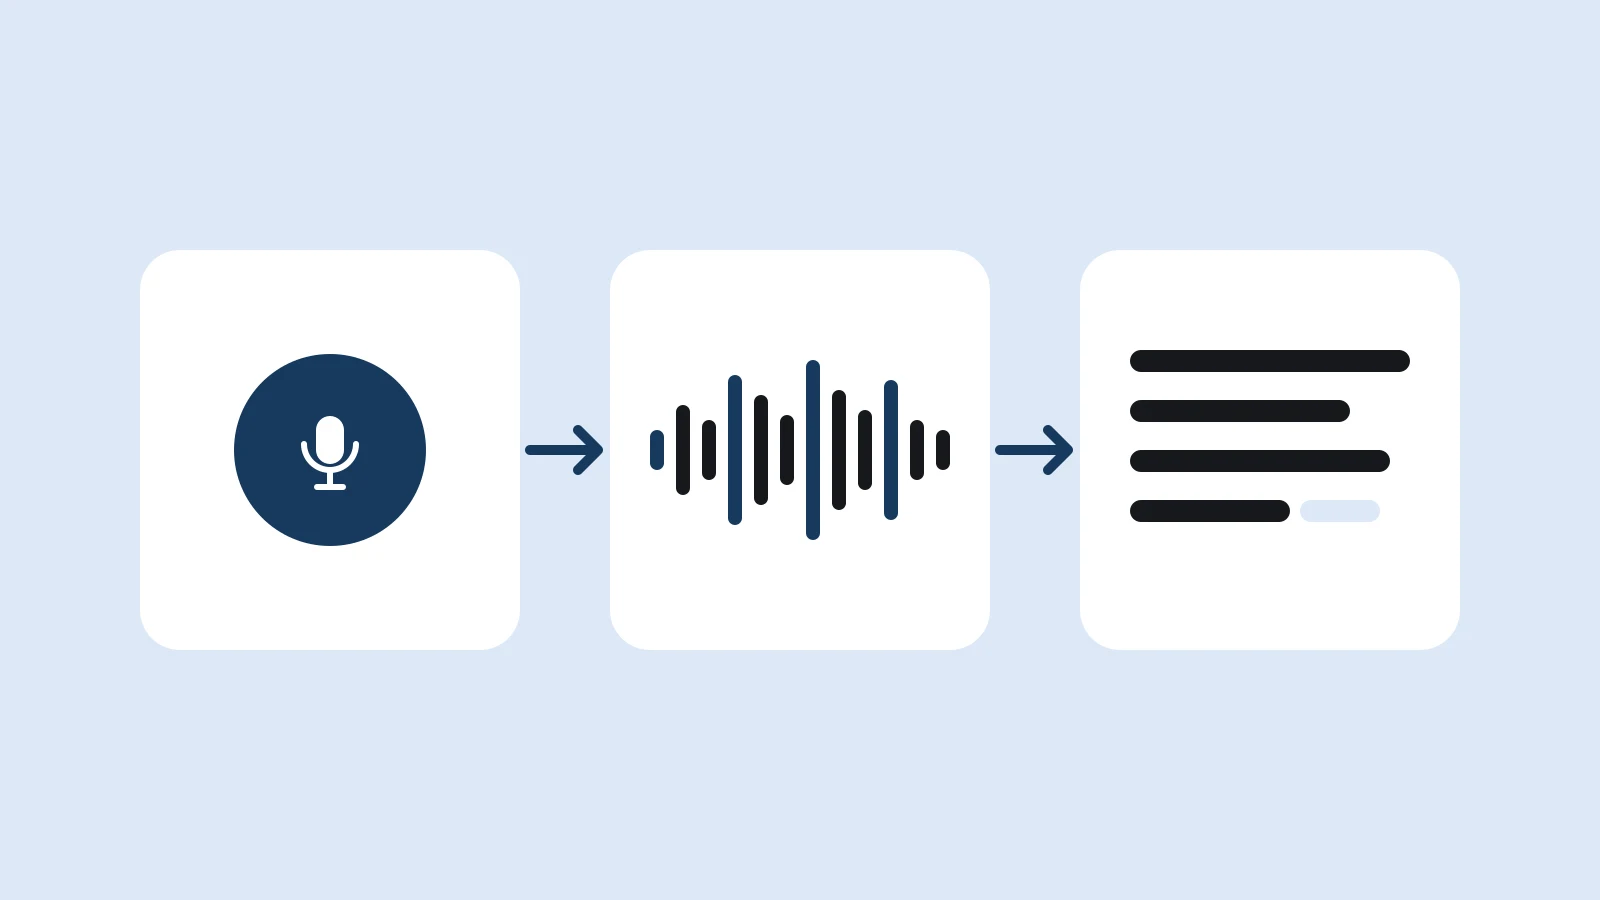
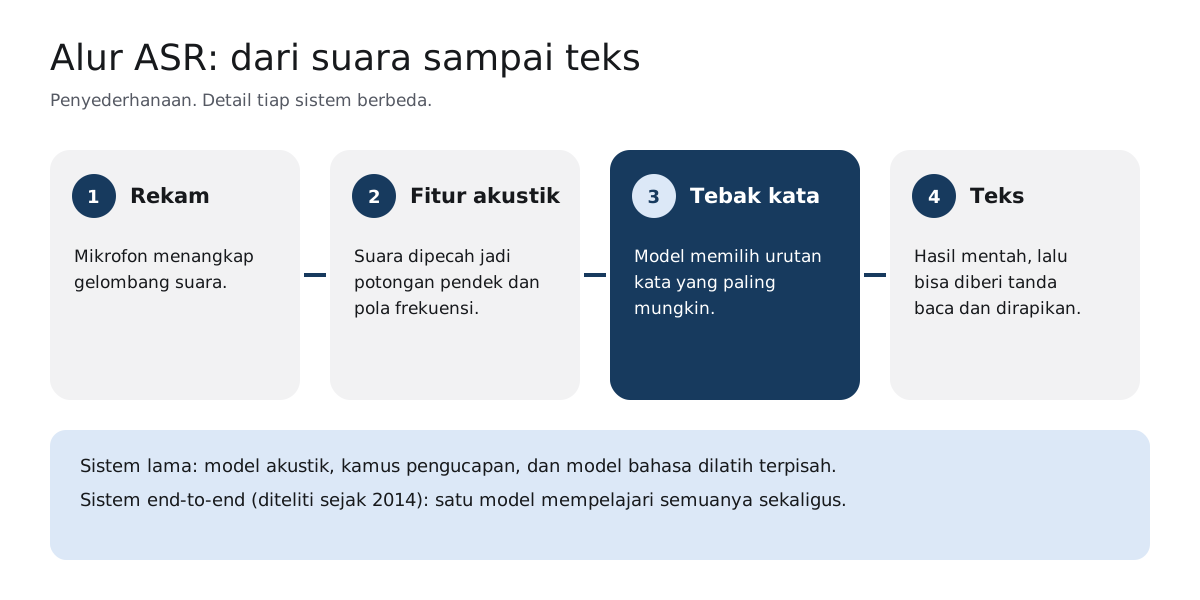
Setiap sistem punya detail berbeda, tetapi alurnya bisa disederhanakan menjadi empat langkah.
1. Merekam suara
Mikrofon mengubah getaran udara menjadi sinyal digital. Di tahap ini kualitas sangat menentukan: suara yang terlalu pelan, terpotong, atau bercampur bising akan tetap jelek di langkah berikutnya, sebaik apa pun modelnya.
2. Mengubah suara menjadi fitur akustik
Sinyal suara dipotong menjadi bagian-bagian sangat pendek, lalu setiap potongan diringkas menjadi pola frekuensi. Hasilnya mirip "sidik jari" bunyi yang lebih mudah diolah mesin daripada gelombang suara mentah.
3. Menebak urutan kata
Inilah inti ASR. Model tidak "mendengar" kata seperti manusia. Ia menghitung kemungkinan: urutan kata mana yang paling cocok dengan pola bunyi ini? Artikel Speech recognition di Wikipedia menjelaskan bahwa pendekatan lama berbasis hidden Markov model (HMM) membutuhkan komponen terpisah untuk pengucapan, akustik, dan bahasa. Model bahasa membantu memilih kalimat yang masuk akal, misalnya "makan nasi" lebih mungkin daripada "makan nasib" walau bunyinya mirip.
Sejak 2014, banyak penelitian beralih ke pendekatan end-to-end, yaitu satu model yang mempelajari semua komponen itu sekaligus. Menurut sumber yang sama, upaya pertama di arah ini adalah sistem berbasis Connectionist Temporal Classification (CTC) yang diperkenalkan Alex Graves dan rekan-rekannya.
4. Menghasilkan dan merapikan teks
Keluaran ASR sering berupa teks mentah: tanpa tanda baca, tanpa huruf kapital, dan masih memuat kata pengisi seperti "eh" atau pengulangan. Sebagian sistem menambahkan langkah perapian, kadang dengan model bahasa terpisah, untuk menambahkan tanda baca dan membuat teks enak dibaca. Bedanya teks mentah dan teks yang sudah dirapikan kami contohkan di panduan cara mengetik dengan suara di Word. Kalau kamu memakai Google Docs, batasan tanda bacanya ada di artikel Google Docs voice typing.
Sejarah singkat speech recognition
ASR bukan teknologi baru. Yang baru adalah seberapa baik ia bekerja untuk percakapan biasa. Tabel berikut merangkum beberapa titik penting dari sumber yang kami kutip.
| Tahun | Peristiwa | Artinya |
|---|---|---|
| 1952 | Peneliti Bell Labs membuat Audrey, sistem pengenal angka untuk satu pembicara | ASR dimulai dari kosakata sangat kecil dan satu suara |
| Era HMM | Sistem memakai komponen terpisah: model akustik, kamus pengucapan, dan model bahasa | Akurasi naik, tetapi tiap komponen harus dilatih dan dirawat sendiri |
| 2014 | Penelitian bergeser ke model end-to-end, dimulai dengan pendekatan CTC | Satu model belajar dari suara ke teks secara langsung |
| 2022 | OpenAI merilis Whisper, dilatih dengan 680.000 jam data suara multibahasa | Satu model bisa dipakai untuk banyak bahasa tanpa pelatihan ulang |
Titik terakhir penting untuk pengguna Bahasa Indonesia. Dalam makalah Robust Speech Recognition via Large-Scale Weak Supervision, Radford dan rekan-rekannya melaporkan bahwa model yang dilatih dengan 680.000 jam data multibahasa dan multitugas bisa bekerja baik pada berbagai tolok ukur tanpa pelatihan tambahan, dan mendekati akurasi serta ketahanan manusia. Model dan kodenya dirilis untuk umum. Sejak itu, membangun produk dikte untuk bahasa selain Inggris menjadi jauh lebih terjangkau.
Cara mengukur akurasi ASR: word error rate
Klaim "akurasi 95 persen" sering muncul di iklan aplikasi, tetapi jarang dijelaskan cara menghitungnya. Ukuran yang paling umum adalah word error rate atau WER. Menurut Wikipedia, WER diturunkan dari jarak Levenshtein yang dihitung per kata: berapa banyak kata yang harus diganti, dihapus, atau disisipkan supaya hasil mesin sama dengan teks acuan.
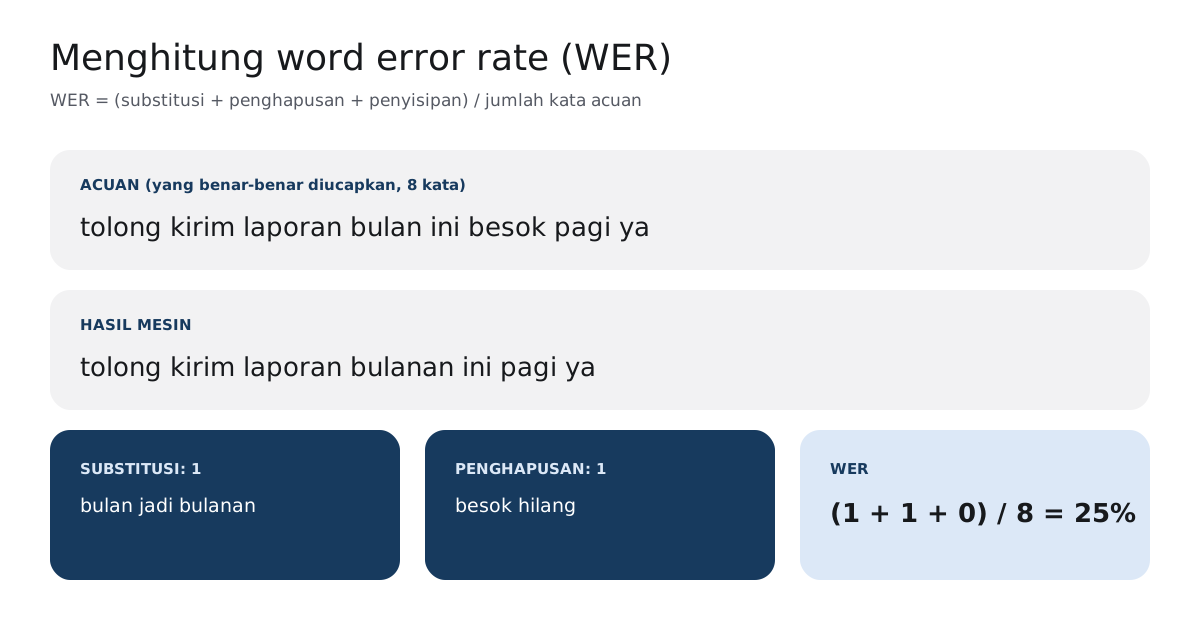
Rumusnya: WER sama dengan jumlah substitusi ditambah penghapusan ditambah penyisipan, dibagi jumlah kata di teks acuan. WER 0 berarti hasilnya sama persis. Pada contoh di atas, satu kata salah dan satu kata hilang dari delapan kata, sehingga WER-nya 25 persen, walau kalimatnya masih bisa dimengerti.
Ada dua hal yang perlu diingat saat membaca angka WER. Pertama, WER tidak membedakan kesalahan kecil dan besar. Salah "bulan" menjadi "bulanan" dihitung sama dengan salah "besok" menjadi "lusa", padahal yang kedua mengubah makna. Kedua, WER sangat bergantung pada jenis rekaman yang diuji. Angka dari rekaman studio yang dibacakan tidak bisa dibandingkan dengan angka dari rapat daring yang ramai.
Cara menguji sendiri
Rekam satu paragraf yang biasa kamu ucapkan saat bekerja, lengkap dengan nama dan istilahmu. Diktekan ke beberapa alat, lalu hitung kata yang salah. Angka dari tes kecil ini lebih relevan untukmu daripada angka di halaman iklan.
Faktor yang memengaruhi akurasi ASR
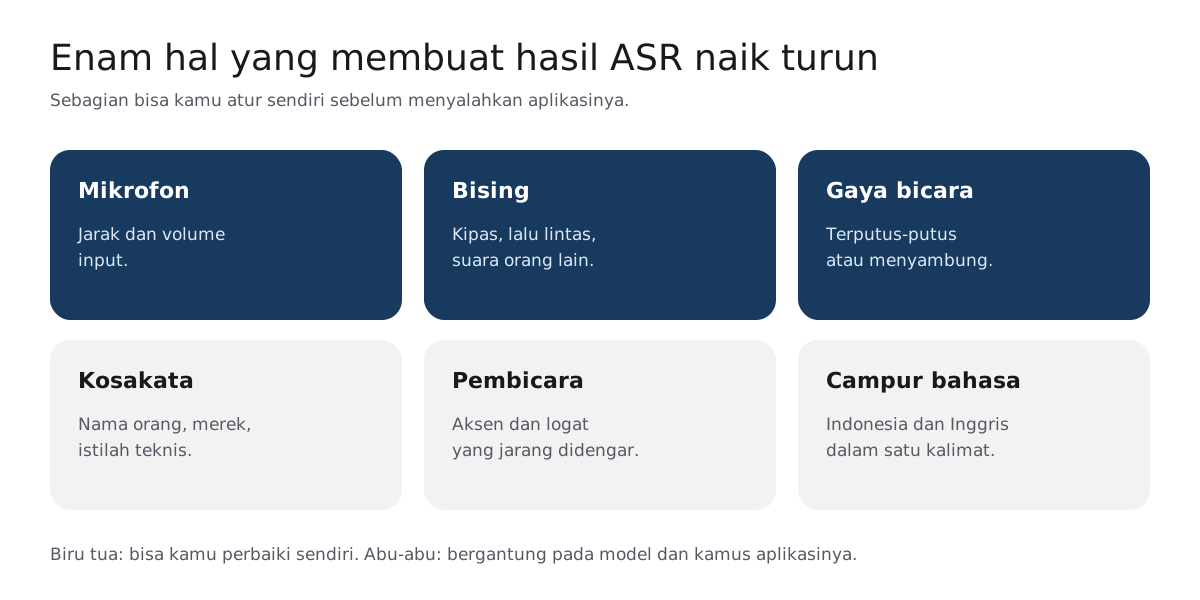
Wikipedia mencatat beberapa faktor yang membuat akurasi speech recognition berbeda-beda. Salah satu contohnya mencolok: sepuluh angka "nol" sampai "sembilan" bisa dikenali hampir sempurna, tetapi tingkat kesalahan naik ketika kosakatanya membesar. Sistem yang dirancang untuk satu pembicara juga lebih mudah dibuat daripada sistem untuk siapa saja, dan ucapan per kata lebih mudah dikenali daripada ucapan yang menyambung.
| Faktor | Kenapa berpengaruh | Yang bisa kamu lakukan |
|---|---|---|
| Mikrofon | Suara pelan atau terpotong kehilangan detail bunyi | Dekatkan mikrofon, cek volume input. Lihat panduan mic laptop tidak berfungsi. |
| Kebisingan | Bunyi lain ikut terekam dan dikira ucapan | Pindah ke ruang lebih tenang atau pakai headset |
| Gaya bicara | Kalimat terputus-putus menyulitkan tebakan kata dan tanda baca | Pikirkan satu kalimat, ucapkan sampai selesai, lalu jeda |
| Kosakata khusus | Nama dan istilah jarang muncul di data latih | Pakai fitur kamus kalau aplikasinya punya, atau koreksi manual |
| Pembicara | Aksen yang jarang ada di data latih lebih sering salah tebak | Bicara sedikit lebih jelas, bukan lebih lambat |
| Campur bahasa | Banyak sistem membaca satu rekaman sebagai satu bahasa | Periksa kata asing setelah dikte. Lihat artikel code switching. |
Faktor terakhir paling terasa bagi pengguna Indonesia. Kalimat kerja kita sering seperti "tolong follow up meeting-nya besok". Bagi manusia itu wajar, tetapi bagi mesin yang memperlakukan seluruh rekaman sebagai Bahasa Indonesia, kata "follow up" bisa ditulis dengan ejaan yang aneh.
ASR dalam kehidupan sehari-hari
Kamu mungkin memakai ASR lebih sering daripada yang disadari. Beberapa contoh yang kami bahas lebih rinci di artikel lain:
- Dikte di laptop. Menulis dokumen atau email dengan suara. Pilihan untuk Bahasa Indonesia di Windows kami bandingkan di panduan cara mengetik dengan suara di laptop, termasuk cara mengetik dengan suara di Word.
- Pesan chat. Membalas pesan tanpa mengetik, seperti di panduan cara mengetik WA dengan suara.
- Transkripsi rekaman. Mengubah rekaman rapat atau wawancara menjadi teks. Bedanya dengan dikte langsung kami jelaskan di artikel ubah suara jadi teks.
- Asisten AI. Bicara dengan ChatGPT atau mendikte prompt. Bedanya mode percakapan dan dikte ada di artikel ChatGPT Voice vs dikte suara, dan cara menyusun prompt yang jelas ada di panduan cara membuat prompt ChatGPT.
Alasan orang beralih ke suara biasanya sederhana: bicara lebih cepat daripada mengetik untuk teks panjang. Angka pembandingnya, beserta catatan soal metodologi, ada di artikel rata-rata kecepatan mengetik.
ASR di balik Artikulasi
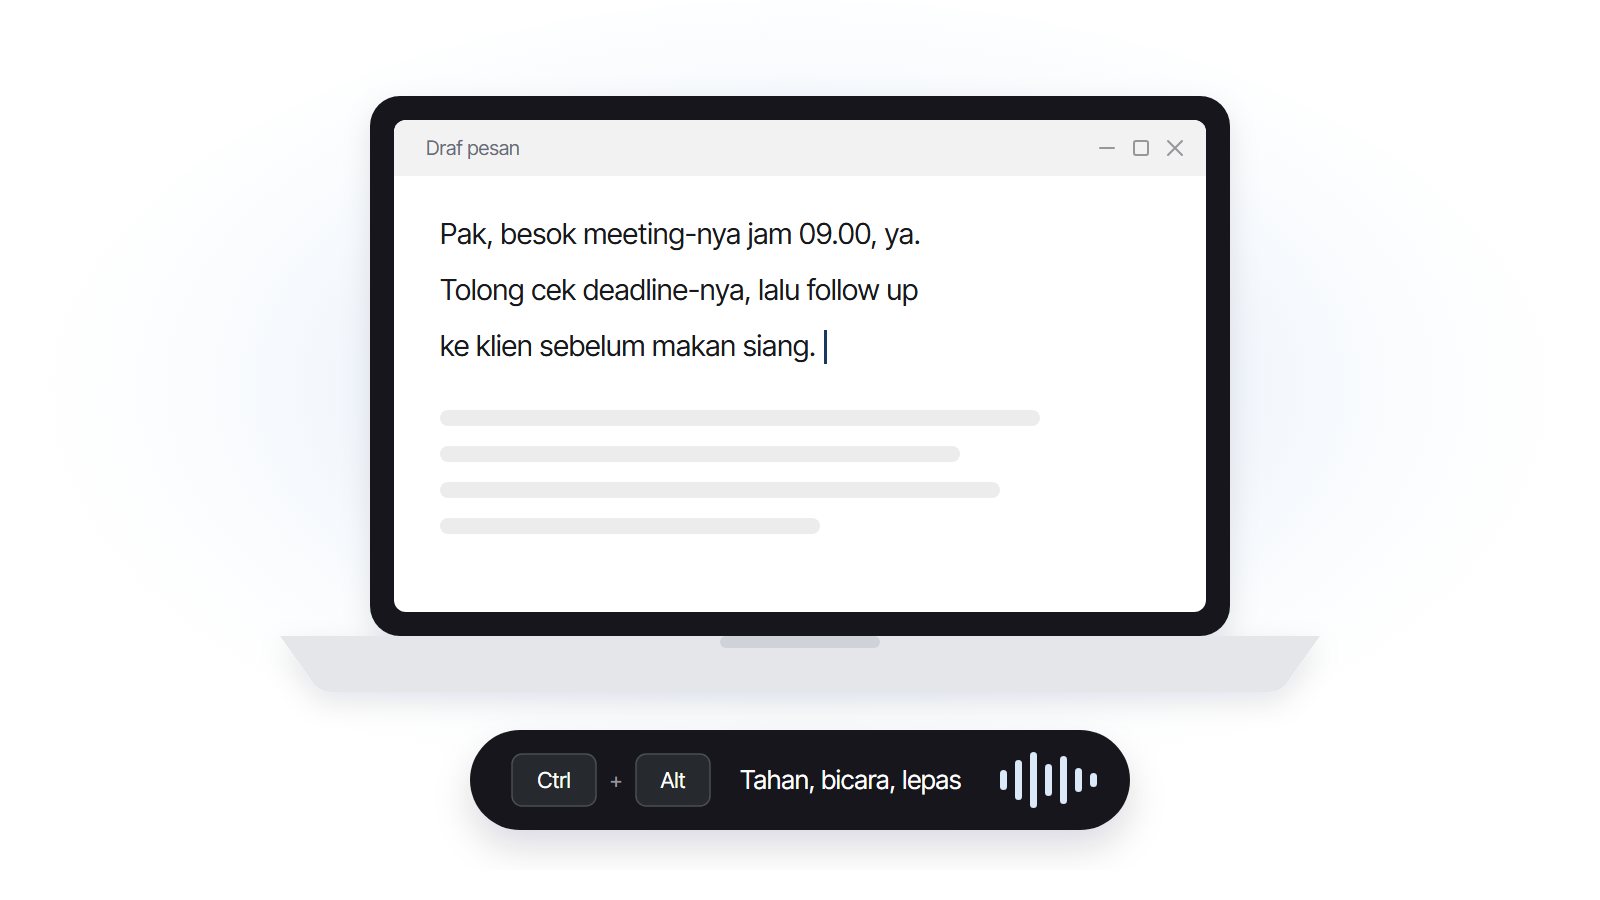
Artikulasi adalah aplikasi mengetik dengan suara untuk Windows yang memakai ASR sebagai langkah pertama, lalu model bahasa untuk merapikan teks: menambahkan tanda baca, membuang kata pengisi, dan menjaga gaya bicaramu. Alurnya, dari tombol yang ditahan sampai teks muncul di posisi kursor, kami jelaskan di halaman cara kerja speech recognition. Perbandingannya dengan alat dikte lain ada di artikel alternatif Wispr Flow.
Status Artikulasi
Versi beta Artikulasi untuk Windows sudah bisa dicoba. Masukkan emailmu di formulir pendaftaran beta, lalu link unduhan dan kode aktivasi kami kirim ke email itu. Pertanyaan lain ada di halaman FAQ.
Jadi, automatic speech recognition adalah mesin penebak yang sangat terlatih: ia mengubah bunyi menjadi pola, lalu memilih urutan kata yang paling mungkin. Memahami cara kerjanya membantumu memilih alat yang tepat, membaca klaim akurasi dengan kritis, dan memperbaiki hal-hal kecil yang membuat hasil dikte jauh lebih baik.
Sumber
- Pengenalan ucapan, Wikipedia bahasa Indonesia (diakses 5 Oktober 2026)
- Speech recognition, Wikipedia (diakses 5 Oktober 2026)
- Word error rate, Wikipedia (diakses 5 Oktober 2026)
- Robust Speech Recognition via Large-Scale Weak Supervision (Radford dkk.), arXiv (diakses 5 Oktober 2026)