Whisper AI adalah model pengenal ucapan sumber terbuka dari OpenAI yang mengubah audio menjadi teks dalam banyak bahasa, termasuk Bahasa Indonesia. Model ini gratis dijalankan sendiri, tersedia dalam beberapa ukuran, dan menjadi mesin di balik banyak aplikasi transkrip dan dikte. Hasilnya untuk Bahasa Indonesia cukup baik, tetapi tetap perlu disunting, terutama untuk nama dan istilah.
Nama Whisper sering muncul saat orang mencari cara mengubah suara menjadi teks. Ada yang menemukannya sebagai perintah di terminal, ada yang memakainya tanpa sadar di dalam aplikasi lain. Artikel ini menjelaskan apa itu Whisper, bagaimana cara kerjanya, model mana yang cocok untuk perangkatmu, dan apa saja keterbatasannya.
Kami juga memakai Whisper di Artikulasi, aplikasi dikte suara Bahasa Indonesia untuk Windows. Di akhir artikel, kami bagikan hasil uji internal kecil kami antara dua varian Whisper pada klip dikte Bahasa Indonesia, lengkap dengan batasan ujinya.
Apa itu Whisper AI
Whisper adalah sistem automatic speech recognition (ASR), yaitu teknologi yang mengubah ucapan menjadi teks. Penjelasan umum tentang ASR, dari cara mesin mendengar sampai kenapa hasilnya bisa salah, ada di artikel kami tentang automatic speech recognition. Whisper adalah salah satu model ASR yang paling banyak dipakai saat ini.
Menurut pengumuman resmi OpenAI, Whisper dilatih dengan 680.000 jam data audio multibahasa dan multitugas yang dikumpulkan dari web. OpenAI menyebut skala dan keragaman data itu membuat Whisper lebih tahan terhadap aksen, bising latar, dan bahasa teknis. Halaman Wikipedia tentang Whisper mencatat tanggal rilisnya 21 September 2022, dan merinci bahwa sekitar 117.000 jam data latih berasal dari 96 bahasa selain Inggris.
Yang membuat Whisper populer bukan hanya kualitasnya, tetapi juga lisensinya. README Whisper menyebut kode dan bobot modelnya dirilis dengan lisensi MIT. Artinya, siapa pun boleh menjalankan, memodifikasi, dan membangun produk di atasnya. Karena itu, banyak aplikasi transkrip, pembuat subtitle, dan alat dikte memakai Whisper di dalamnya.
Whisper bisa mengerjakan beberapa tugas: menulis transkrip dalam bahasa aslinya, mengenali bahasa yang diucapkan, memberi penanda waktu per segmen, dan menerjemahkan ucapan dari bahasa lain ke bahasa Inggris. Yang tidak bisa dilakukannya: menerjemahkan dari bahasa Inggris ke Bahasa Indonesia, atau mengetik langsung di aplikasi yang sedang kamu buka.
Cara kerja Whisper secara sederhana
Whisper memakai arsitektur Transformer dengan pasangan encoder dan decoder. Kamu tidak perlu memahami detail matematikanya untuk memakai Whisper, tetapi gambaran alurnya membantu menjelaskan kenapa hasilnya kadang salah.
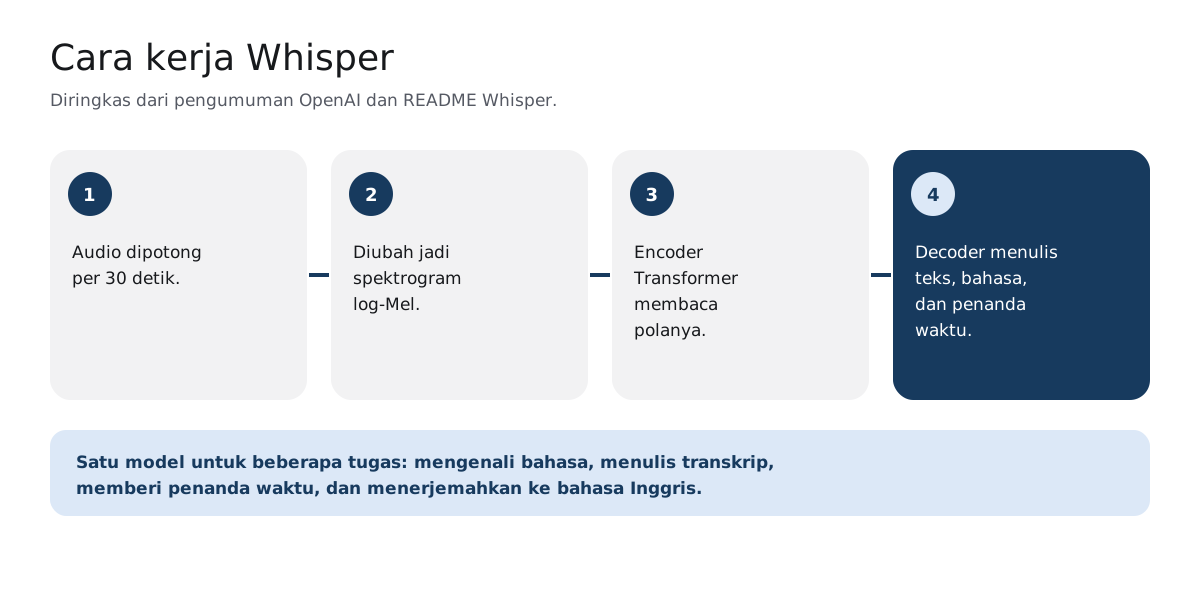
- Audio dipotong per 30 detik. Rekaman panjang diproses potongan demi potongan.
- Potongan diubah menjadi spektrogram log-Mel. Ini semacam gambar yang menunjukkan kekuatan tiap frekuensi suara dari waktu ke waktu.
- Encoder membaca pola dalam spektrogram. Bagian ini mengubah gambar suara menjadi representasi yang bisa dipahami model.
- Decoder menulis teks. Teks ditulis bersama token khusus yang memberi tahu model tugasnya, misalnya bahasa apa, perlu penanda waktu atau tidak, dan transkrip atau terjemahan.
Karena decoder menulis teks dengan menebak kata berikutnya, Whisper cenderung menghasilkan kalimat yang terdengar wajar. Ini kekuatan sekaligus kelemahan. Tanda baca dan huruf kapital biasanya rapi, tetapi saat audionya tidak jelas, model bisa menulis kalimat yang wajar namun tidak pernah diucapkan.
Ukuran model Whisper dan kebutuhan perangkat
Whisper tersedia dalam beberapa ukuran. Model kecil lebih cepat dan ringan, model besar lebih akurat tetapi butuh memori kartu grafis (VRAM) lebih banyak. Angka berikut kami ambil dari README Whisper.
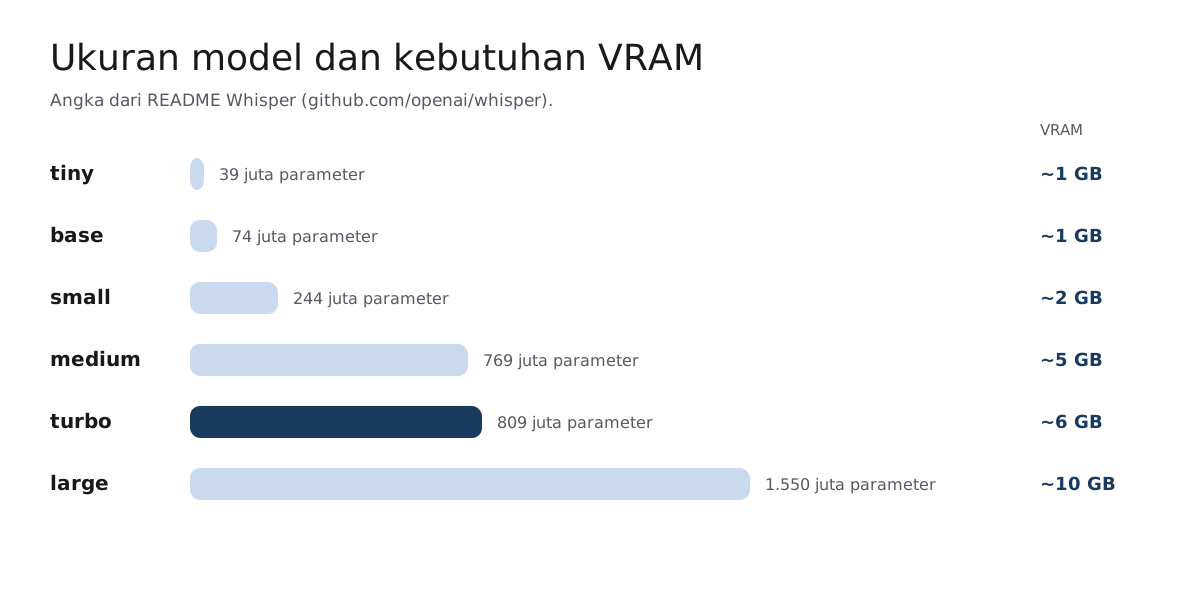
| Model | Parameter | Perkiraan VRAM | Kecepatan relatif terhadap large |
|---|---|---|---|
| tiny | 39 juta | sekitar 1 GB | sekitar 10 kali |
| base | 74 juta | sekitar 1 GB | sekitar 7 kali |
| small | 244 juta | sekitar 2 GB | sekitar 4 kali |
| medium | 769 juta | sekitar 5 GB | sekitar 2 kali |
| turbo | 809 juta | sekitar 6 GB | sekitar 8 kali |
| large | 1.550 juta | sekitar 10 GB | 1 kali (acuan) |
README Whisper menjelaskan bahwa kecepatan relatif itu diukur saat mentranskrip ucapan bahasa Inggris di GPU A100, dan kecepatan nyata bisa sangat berbeda tergantung bahasa, kecepatan bicara, dan perangkat. Turbo disebut sebagai versi large-v3 yang dioptimalkan untuk kecepatan dengan penurunan akurasi yang minimal. Ada juga varian khusus bahasa Inggris (berakhiran .en) untuk ukuran tiny sampai medium, yang tidak relevan untuk Bahasa Indonesia.
Untuk laptop kantor tanpa kartu grafis terpisah, model kecil seperti base atau small masih bisa dijalankan di CPU, tetapi kualitas Bahasa Indonesia-nya jelas di bawah model besar. Kalau kamu butuh hasil terbaik tanpa GPU sendiri, pilihan yang lebih praktis adalah memakai Whisper lewat penyedia atau aplikasi.
Tiga cara memakai Whisper
Ada tiga jalur utama, dan masing-masing punya pertukaran antara biaya, kemudahan, dan privasi.
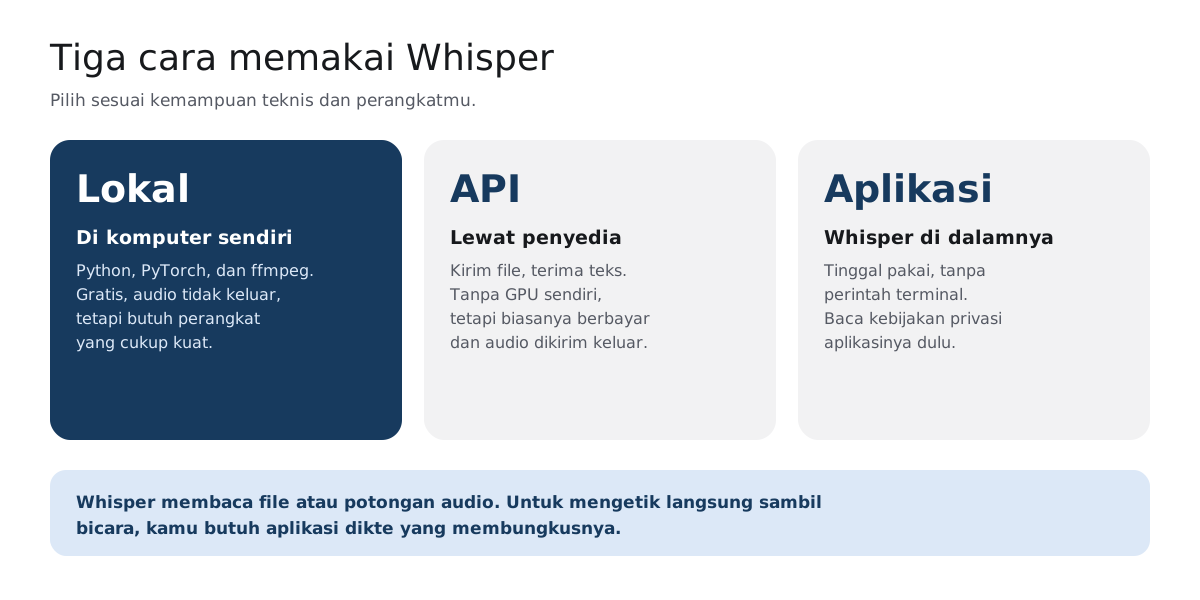
| Cara | Yang dibutuhkan | Kelebihan | Pertimbangan |
|---|---|---|---|
| Jalankan lokal | Python, PyTorch, ffmpeg, idealnya GPU | Gratis, audio tidak keluar dari komputer | Perlu terbiasa dengan terminal; lambat tanpa GPU |
| Lewat API penyedia | Akun dan kunci API | Cepat tanpa perangkat kuat | Biasanya berbayar atau dibatasi kuota; audio diproses di server penyedia |
| Lewat aplikasi | Aplikasi transkrip atau dikte yang memakai Whisper | Tinggal pakai, tanpa perintah | Baca kebijakan privasi dan batas pemakaian aplikasinya |
Menjalankan Whisper di komputer sendiri
Menurut README, kamu butuh Python, PyTorch, dan program ffmpeg yang terpasang di sistem. Di Windows, ffmpeg bisa dipasang lewat pengelola paket seperti Chocolatey atau Scoop. Setelah itu, pasang Whisper dengan pip:
pip install -U openai-whisperUntuk mentranskrip rekaman Bahasa Indonesia, sebutkan bahasanya secara eksplisit supaya model tidak salah menebak:
whisper rekaman.mp3 --model turbo --language IndonesianSecara bawaan, Whisper menulis hasil dalam beberapa format sekaligus: teks biasa (txt), subtitle (srt dan vtt), tabel (tsv), dan JSON. Pilih satu dengan opsi --output_format, misalnya --output_format srt untuk subtitle video. Ada juga opsi --initial_prompt untuk memberi contoh teks atau daftar istilah, yang bisa membantu ejaan nama dan istilah khusus.
Lewat API atau aplikasi
Kalau tidak ingin repot dengan instalasi, beberapa penyedia menjalankan model Whisper di server mereka dan membukanya lewat API. Kamu mengirim file audio, lalu menerima teks. Artikulasi sendiri memanggil whisper-large-v3 lewat penyedia inferensi Groq dari server kami. Untuk pemakaian sehari-hari, aplikasi transkrip atau dikte yang memakai Whisper biasanya paling praktis. Pilihan alat untuk mengubah file rekaman menjadi teks kami bandingkan di artikel ubah suara jadi teks.
Seberapa bagus Whisper untuk Bahasa Indonesia
Bahasa Indonesia ada di daftar bahasa Whisper, begitu juga bahasa Jawa dan Sunda. Namun README Whisper menegaskan bahwa performanya sangat bervariasi antarbahasa, dan menampilkan grafik tingkat kesalahan kata (word error rate) per bahasa. Bahasa dengan data latih lebih sedikit cenderung punya tingkat kesalahan lebih tinggi.
Dari pemakaian kami, ada pola yang konsisten untuk ucapan Bahasa Indonesia sehari-hari:
- Kalimat formal dan jelas umumnya ditranskrip dengan baik, lengkap dengan tanda baca.
- Nama orang, merek lokal, dan singkatan paling sering salah eja, karena jarang muncul di data latih.
- Kalimat campur Indonesia dan Inggris kadang membuat model menebak ejaan yang salah untuk salah satu bahasanya. Fenomena ini kami bahas di artikel code switching dan bahasa Jaksel.
- Kata yang bunyinya mirip bisa tertukar, terutama di audio yang kurang jernih.
Uji internal kami: large-v3 dan turbo
Saat membangun Artikulasi, kami membandingkan whisper-large-v3 dan whisper-large-v3-turbo pada klip dikte pendek Bahasa Indonesia yang dikirim lewat Groq. Ini uji kecil internal untuk memilih model aplikasi, bukan tolok ukur akurasi resmi, jadi hasilnya jangan dibaca sebagai angka pasti.
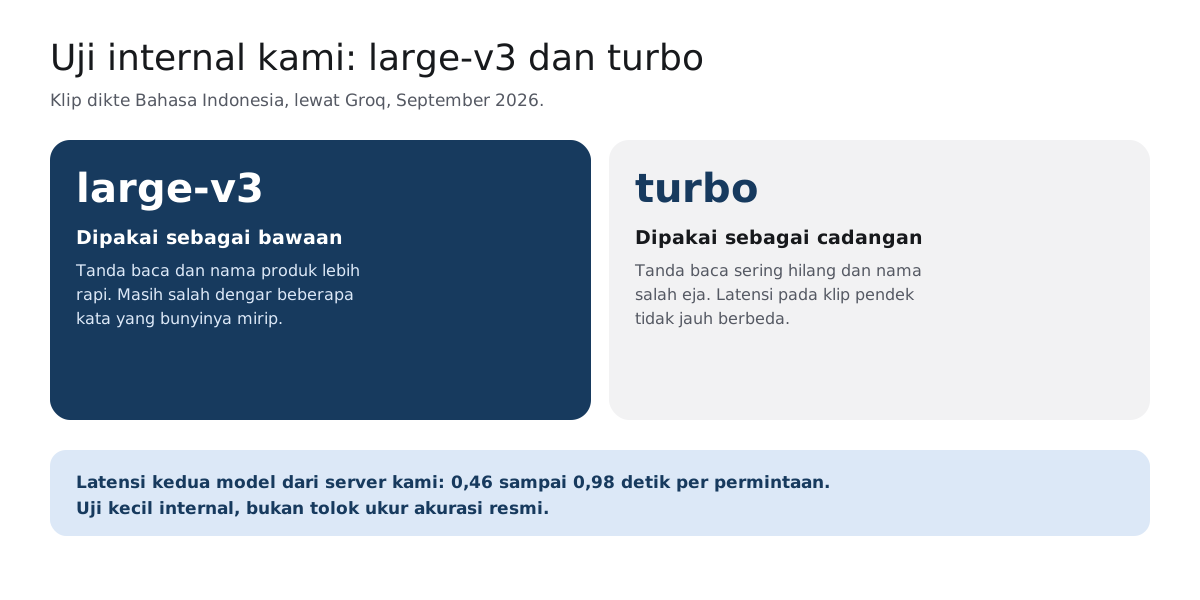
Hasilnya: large-v3 lebih rapi untuk tanda baca dan nama produk, sedangkan turbo lebih sering membuang tanda baca dan salah mengeja nama. Latensi keduanya dari server kami sama-sama sekitar 0,46 sampai 0,98 detik per permintaan untuk klip pendek. Kedua model masih salah dengar pada beberapa kata yang bunyinya mirip. Karena itu kami memakai large-v3 sebagai bawaan, turbo sebagai cadangan, ditambah tahap perapian teks dan kamus pribadi untuk nama yang sering salah.
Kami juga menemukan satu jebakan praktis: saat prompt untuk Whisper berisi daftar istilah yang tidak diakhiri tanda titik, model pernah berhenti menulis di tengah klip. Setelah prompt selalu ditutup dengan titik, transkripnya kembali lengkap. Kalau kamu memakai --initial_prompt, tulis promptnya sebagai kalimat utuh.
Tips agar hasil Whisper Bahasa Indonesia lebih rapi
Sebagian besar kesalahan transkrip bisa dikurangi sebelum model bekerja. Kebiasaan berikut berlaku baik saat kamu menjalankan Whisper sendiri maupun memakai aplikasi yang memakainya:
- Rekam sedekat mungkin dengan mulut pembicara. Suara yang jauh dan bergema adalah penyebab salah dengar paling umum. Kalau mikrofon laptopmu bermasalah, cek dulu panduan mic laptop tidak berfungsi.
- Sebutkan bahasa secara eksplisit. Dengan opsi
--language Indonesian, model tidak perlu menebak bahasa dari potongan awal, yang bisa keliru kalau rekaman dibuka dengan kalimat bahasa Inggris. - Beri prompt berisi istilah penting. Tulis sebagai kalimat utuh yang diakhiri titik, misalnya daftar nama narasumber dan merek yang akan disebut.
- Potong bagian hening yang panjang. Bagian tanpa ucapan adalah tempat halusinasi paling sering muncul.
- Pilih model sebesar yang sanggup dijalankan perangkatmu. Untuk Bahasa Indonesia, selisih kualitas model kecil dan besar terasa jelas.
- Sunting dengan aturan ejaan. Tanda baca dari model umumnya wajar, tetapi aturan seperti koma setelah anak kalimat atau penulisan angka tetap perlu dicek. Ringkasannya ada di panduan tanda baca bahasa Indonesia.
Untuk dikte langsung, prinsipnya sama: ucapkan satu kalimat utuh sebelum berhenti, jangan memotong di tengah kata, dan biarkan tahap perapian merapikan kata pengisi. Kebiasaan ini juga membuat hasil dikte di aplikasi apa pun lebih bersih.
Keterbatasan Whisper yang perlu kamu tahu
Whisper sangat berguna, tetapi bukan tanpa kelemahan. Beberapa hal berikut penting sebelum kamu memakai hasilnya untuk pekerjaan serius:
- Halusinasi. Wikipedia merangkum beberapa pengujian pihak ketiga yang menemukan teks yang tidak pernah diucapkan muncul di transkrip. Ini paling berisiko di bagian hening atau audio buruk.
- Bukan alat dikte. Whisper memproses audio yang sudah direkam. Untuk mengetik sambil bicara, kamu butuh aplikasi yang merekam, mengirim audio ke model, lalu menempelkan hasilnya.
- Label pembicara tidak bawaan. Whisper tidak memisahkan siapa yang bicara. Untuk wawancara, kamu perlu memberi label sendiri atau memakai alat tambahan. Langkahnya ada di panduan transkrip wawancara.
- Terjemahan hanya ke bahasa Inggris. README juga menyebut model turbo tidak dilatih untuk tugas terjemahan.
- Butuh perangkat kuat untuk model besar. Tanpa GPU, model large dan turbo berjalan lambat di CPU.
Whisper dan dikte suara sehari-hari
Banyak orang mencari Whisper karena ingin berhenti mengetik panjang. Untuk kebutuhan itu, model saja belum cukup. Kamu butuh alur lengkap: menekan tombol, bicara, model mengenali ucapan, teks dirapikan, lalu ditempel di aplikasi yang sedang dipakai. Pilihan dikte bawaan Windows dan alternatifnya kami bahas di panduan cara mengetik dengan suara di laptop, termasuk khusus untuk Microsoft Word dan Google Docs.
Artikulasi adalah salah satu contoh aplikasi seperti itu. Kamu menahan satu tombol, bicara campur Indonesia dan Inggris, lalu teks yang sudah bertanda baca muncul di aplikasi apa pun di Windows. Penjelasan alurnya ada di halaman cara kerja dan fitur. Kalau kamu sedang membandingkan aplikasi dikte, lihat juga artikel alternatif Wispr Flow dan ChatGPT Voice.
Kesimpulan
Whisper AI adalah model pengenal ucapan sumber terbuka dari OpenAI yang dilatih dengan 680.000 jam audio, berlisensi MIT, dan mendukung Bahasa Indonesia. Pilih ukuran model sesuai perangkatmu, sebutkan bahasa secara eksplisit, dan beri prompt berisi istilah penting untuk ejaan yang lebih baik. Ingat keterbatasannya: halusinasi pada audio buruk, tanpa label pembicara, dan bukan alat dikte langsung. Untuk transkrip penting, selalu dengarkan ulang. Untuk menulis sehari-hari, pakai aplikasi yang membungkus Whisper menjadi alur dikte yang utuh.
Sumber
- Introducing Whisper, OpenAI (diakses 10 Oktober 2026)
- Whisper (README), OpenAI di GitHub (diakses 10 Oktober 2026)
- Whisper tokenizer.py (daftar bahasa), OpenAI di GitHub (diakses 10 Oktober 2026)
- Robust Speech Recognition via Large-Scale Weak Supervision, arXiv (diakses 10 Oktober 2026)
- Whisper (speech recognition system), Wikipedia (diakses 10 Oktober 2026)